NVIDIA lança PAIR em código aberto: como o roteador de inferência local une GPUs RTX, Mac e Ollama para destravar agentes de IA

Se você já tentou rodar fluxos com múltiplos agentes autônomos de IA ou ferramentas avançadas de código em hardware local, certamente esbarrou no mesmo gargalo: quando vários subagentes começam a disparar chamadas simultâneas de modelos, uma única GPU doméstica tem sua fila de inferência saturada em poucos segundos. Para resolver essa dor sem exigir que você compre um servidor de data center ou assine APIs em nuvem, a NVIDIA apresentou oficialmente o NVIDIA PAIR (Personal AI Router), um roteador virtual de inferência em código aberto projetado para distribuir chamadas locais de IA por todos os computadores disponíveis na sua rede doméstica ou homelab.
O grande atrativo da ferramenta está na sua simplicidade arquitetural: o PAIR atua como um proxy transparente sobre os servidores locais que a comunidade já utiliza amplamente — como Ollama e LM Studio —, funcionando em sistemas com placas NVIDIA GeForce RTX (da série RTX 20 em diante), estações de trabalho RTX PRO, nós DGX Spark e até computadores Apple Silicon (chips M4 ou superiores).
O que é o NVIDIA PAIR e por que ele é diferente de clusters tradicionais?
Diferente de soluções corporativas como Kubernetes, Slurm ou frameworks de paralelismo de tensores (que tentam dividir o processamento de um único modelo entre múltiplas GPUs interconectadas por barramentos ultra-rápidos), o NVIDIA PAIR foca em concorrência a nível de tarefas (workload-level concurrency).
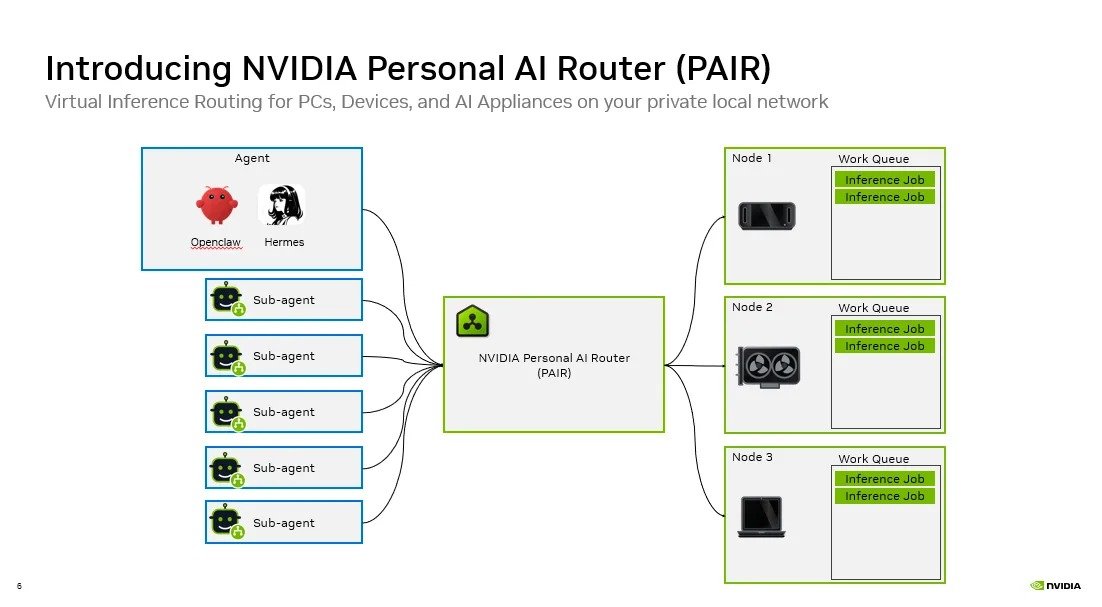
Em fluxos modernos de agentes de IA — como os executados pelo Hermes Desktop, CrewAI, AutoGen, Claude Code ou interfaces de assistência de programação —, um agente principal decompõe um objetivo em múltiplos subagentes especializados. Cada subagente precisa pesquisar fontes, auditar código, formatar dados ou redigir relatórios de forma independente. No nível do motor de inferência, isso se traduz em dezenas de chamadas avulsas ao modelo.
Em um setup comum de uma única máquina, essas requisições ficam presas em fila única, elevando a latência e o consumo de VRAM (especialmente com o cache de chaves/valores de contexto, o KV cache). Com o PAIR ativo na rede local, cada requisição independente é interceptada e despachada para um nó diferente da rede que esteja ocioso e com o modelo já carregado.
Compatibilidade de hardware e ecossistema dinâmico
Uma das maiores preocupações em homelabs e residências é a natureza dinâmica do hardware: um computador de jogos não fica ligado 24/7 apenas para servir inferência, um notebook pode ser fechado para transporte a qualquer instante e uma estação de trabalho pode ter sua GPU requisitada pelo usuário para renderização ou jogos.
O PAIR foi desenvolvido justamente para lidar com essa elasticidade sem derrubar o cluster. Se você iniciar um jogo pesado no PC principal, o PAIR detecta a ocupação da GPU e passa a rotear as chamadas dos subagentes automaticamente para as outras máquinas pareadas na rede.
| Característica | Especificação / Detalhe do NVIDIA PAIR |
|---|---|
| Tipo de Software | Roteador virtual de inferência (Virtual Inference Router), Open Source |
| Sistemas Operacionais | Windows 11/10, macOS (Apple Silicon M4+) e Linux (Ubuntu, Debian, Fedora, Arch) |
| GPUs Suportadas | NVIDIA GeForce RTX série 20 (Turing), 30 (Ampere), 40 (Ada Lovelace) e 50 (Blackwell); GPUs RTX PRO / Quadro |
| Outros Chips Suportados | NVIDIA DGX Spark e Apple Silicon (M4, M4 Pro, M4 Max) |
| Motores de Inferência | Ollama e LM Studio (integração nativa de portas e APIs) |
| Descoberta e Segurança | Descoberta automática via mDNS na LAN e comunicação criptografada por mTLS com certificados dedicados |
| Modo de Distribuição | Roteamento por requisição independente (1 chamada inteira = 1 nó elegível) |
Arquitetura técnica: proxy transparente sem alterar o código dos agentes
Para quem desenvolve ou utiliza ferramentas de IA, uma das maiores vantagens do PAIR é não exigir nenhuma refatoração em scripts, agentes ou frameworks. O PAIR assume a porta local padrão utilizada pelo Ollama (como a porta 11434) ou pelo LM Studio (1234) na máquina do usuário.
Quando o harness do seu agente envia uma requisição padrão REST/OpenAI-compatible para localhost:11434, o proxy do PAIR analisa dois metadados principais: o motor solicitado e o nome/tag do modelo. A partir daí, o agendador consulta sua tabela interna de nós pareados e seleciona a melhor máquina disponível.
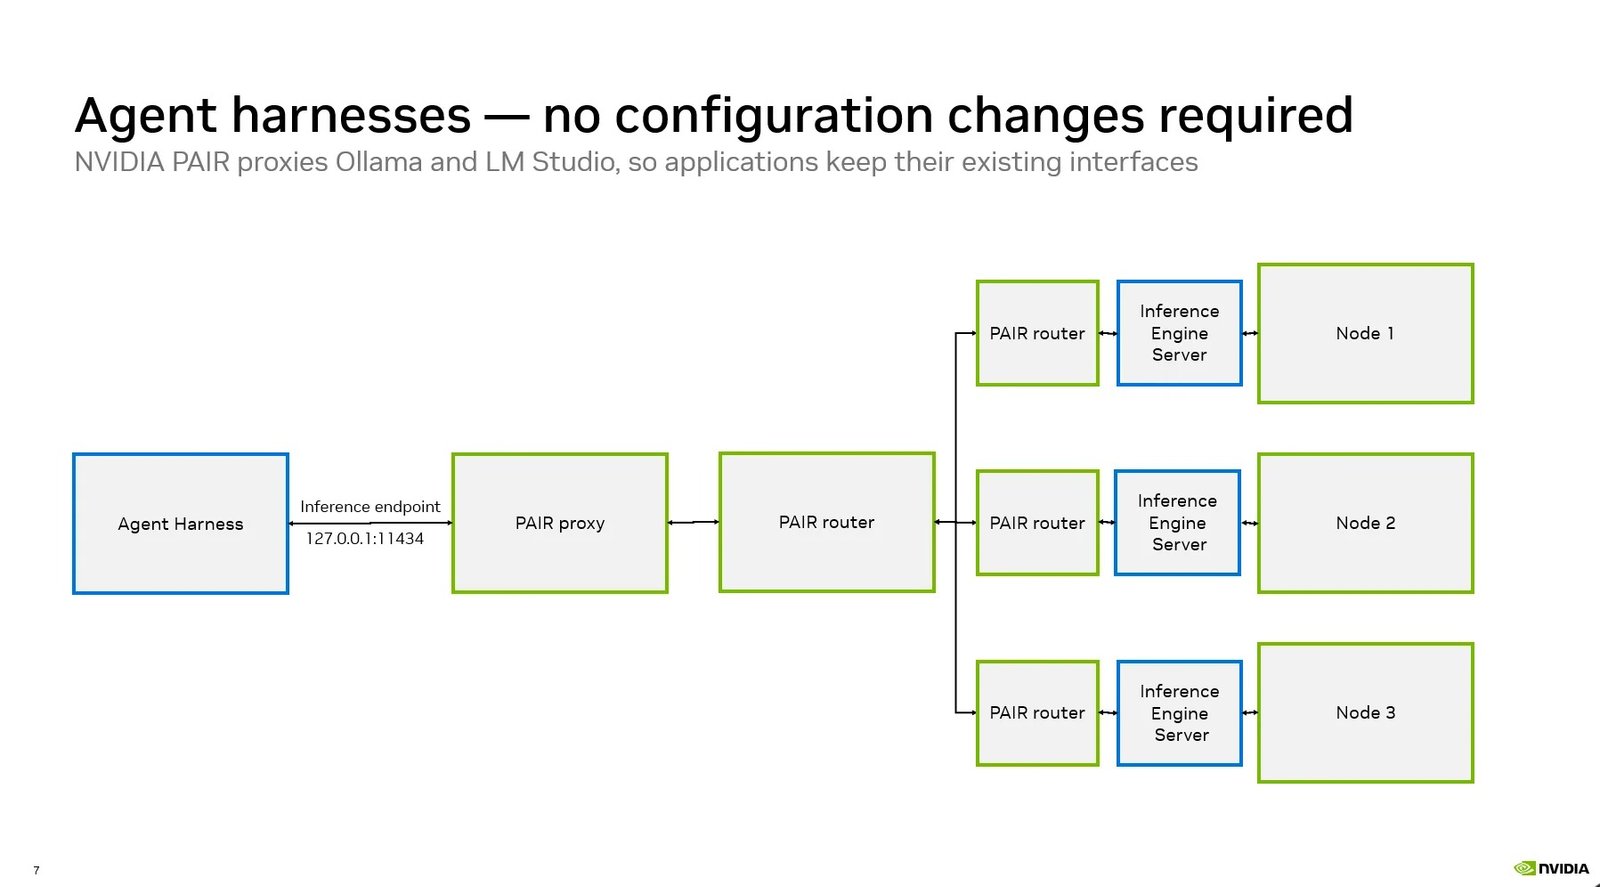
O agendador do PAIR avalia os nós participantes com base em critérios objetivos:
- Prontidão e estado do nó: se a máquina está online, respondendo ao heartbeat e com o serviço Ollama/LM Studio ativo.
- Presença do modelo em disco: se a máquina já possui o modelo baixado no armazenamento local (evitando downloads demorados no meio da execução).
- Ocupação atual da GPU e memória: se a GPU está livre para aceitar uma nova tarefa ou se já está com slots de inferência cheios.
Teste prático: 5 subagentes com Hermes Desktop e Ollama
Para demonstrar o impacto do roteamento em cenários reais de produtividade, a equipe de engenharia da NVIDIA publicou um caso de uso utilizando o Hermes Desktop configurado com 5 subagentes trabalhando em paralelo. A tarefa consistia em analisar uma caixa de entrada complexa, cruzar evidências, verificar dados e consolidar um plano de ação completo.
O modelo utilizado nos testes foi o Qwen 3.6 35B A3B rodando via Ollama:
- Em um único laptop com GPU RTX Spark: a carga de trabalho levou em média 18 minutos para ser finalizada, devido ao enfileiramento sequencial das chamadas dos subagentes na mesma GPU.
- Em um cluster PAIR de 3 dispositivos (Laptop RTX Spark + DGX Spark + desktop com RTX 5090): o mesmo fluxo foi concluído em apenas 8 minutos e 48 segundos.
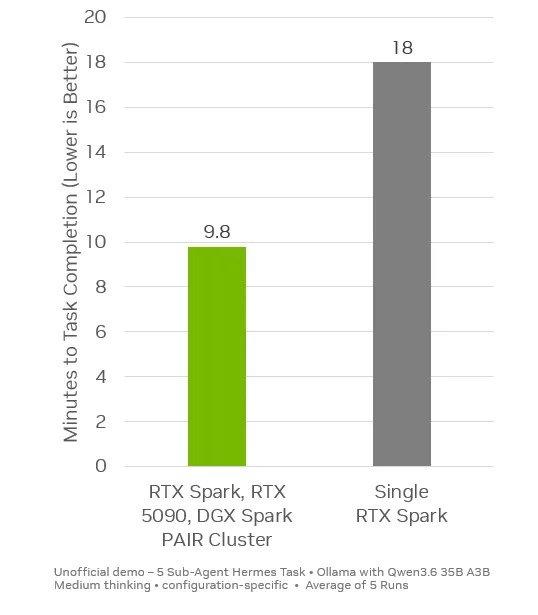
O resultado demonstra que, em tarefas com paralelismo intrínseco (onde vários agentes pesquisam ou processam partes diferentes de um problema simultaneamente), somar máquinas que já existem na casa reduz o tempo de espera pela metade sem nenhum custo adicional de infraestrutura.
O que está confirmado e o que ainda é limitação técnica?
Para quem pensa em adotar o NVIDIA PAIR no dia a dia, é essencial separar as capacidades reais das expectativas irreais:
O que está confirmado e validado:
- Código aberto: o projeto tem repositório público com código auditável para descoberta mDNS, roteamento, mTLS e interfaces de usuário (GUI e CLI).
- Zero lock-in no ecossistema: compatibilidade direta com Ollama e LM Studio, permitindo usar qualquer modelo GGUF ou safetensors suportado por esses motores (Llama 3, Qwen, DeepSeek, Gemma, Mistral, etc.).
- Heterogeneidade real: você pode parear um desktop com RTX 3060 de 12 GB, um mini PC com RTX 4070 e um Mac Studio M4 na mesma malha.
- Privacidade total: todo o tráfego de inferência permanece estritamente confinado à rede local do usuário, com autenticação mTLS mútua.
O que ainda é limitação ou requer atenção:
- Não há divisão de modelo único (Tensor Parallelism via LAN): o PAIR não permite rodar um modelo de 70B dividindo os parâmetros entre duas placas de 12 GB na rede local. Cada nó precisa conseguir carregar e executar o modelo individualmente.
- Dependência da rede local: embora a inferência ocorra localmente em cada GPU, o envio de prompts grandes com documentos extensos e o streaming de tokens dependem da estabilidade da sua rede (Wi-Fi 6 ou cabos Ethernet Gigabit/2.5G são fortemente recomendados).
- Modelos precisam estar pré-baixados: o scheduler prioriza nós que já possuam a tag exata do modelo. Se apenas um nó tiver o modelo solicitado, todas as chamadas irão para ele, anulando o ganho de concorrência.
Como começar a testar o NVIDIA PAIR no seu ambiente
Para quem deseja experimentar a versão beta do PAIR:
- Instalação do binário: baixe a versão beta do PAIR para o seu sistema operacional principal (Windows, Linux ou macOS).
- Configuração dos nós: instale o PAIR e certifique-se de que o Ollama ou LM Studio esteja rodando em cada máquina da rede com os modelos desejados já baixados (ex:
ollama pull qwen2.5:14bouollama pull llama3.3:70b). - Pareamento seguro: abra a interface do PAIR; o software utilizará mDNS para localizar os outros nós na rede. Aprove as solicitações de pareamento em cada dispositivo para gerar os certificados mTLS.
- Execução transparente: aponte suas ferramentas de agentes (Hermes, Claude Code, Cursor, AutoGen, scripts Python) para o endpoint local padrão. O painel Jobs do PAIR mostrará em tempo real quais requisições estão sendo processadas por cada máquina.
Perguntas Frequentes (FAQ)
O NVIDIA PAIR substitui o Ollama ou o LM Studio?
Não. O PAIR não é um motor de inferência, mas sim um orquestrador e proxy inteligente. Ele precisa que o Ollama ou o LM Studio continue instalado e executando os modelos em cada máquina do cluster.
Preciso de GPUs com a mesma quantidade de VRAM em todas as máquinas?
Não. Os computadores podem ter configurações completamente diferentes (por exemplo, um desktop com 24 GB de VRAM e um notebook com 8 GB). O único requisito é que o nó selecionado tenha capacidade suficiente para rodar o modelo específico requisitado naquela chamada.
O PAIR funciona com placas de vídeo AMD Radeon ou GPUs Intel Arc?
Nesta fase inicial de beta, o suporte oficial e as métricas avançadas de GPU do PAIR são homologados para placas NVIDIA GeForce RTX (série 20 em diante), GPUs RTX PRO, DGX Spark e chips Apple Silicon M4+. Placas AMD Radeon e Intel Arc não possuem suporte oficial garantido pelo agendador de métricas da NVIDIA no momento.
Existe custo de licença para usar o NVIDIA PAIR?
Não. O NVIDIA PAIR foi disponibilizado como projeto de código aberto (open-source), sem taxas de assinatura ou custos de licença para uso pessoal e em homelabs.
Fontes e documentação técnica
- NVIDIA Technical Blog: “NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network” (Setembro de 2026) — Acesse o artigo oficial
- Repositório do Projeto: Código-fonte, documentação de integração mTLS e instaladores beta do Personal AI Router no GitHub oficial da NVIDIA.
- NVIDIA Developer Hub: Guias de aceleração de IA local, Ollama e ecossistema RTX AI PC.