AMD libera Qwen3.8 27B em Ryzen AI Max: IA local começa a exigir mais de 24 GB de memória gráfica

A AMD entrou na corrida da IA local com um gancho bem prático para quem acompanha PCs de alto desempenho: a empresa anunciou suporte no primeiro dia ao Qwen3.8 27B em máquinas com Ryzen AI Max+ e em GPUs Radeon AI PRO. A notícia importa porque desloca parte do debate de “qual modelo é melhor na nuvem” para uma pergunta mais útil para o usuário brasileiro: que tipo de hardware realmente permite rodar modelos grandes localmente sem depender de assinatura, fila ou custo por token?
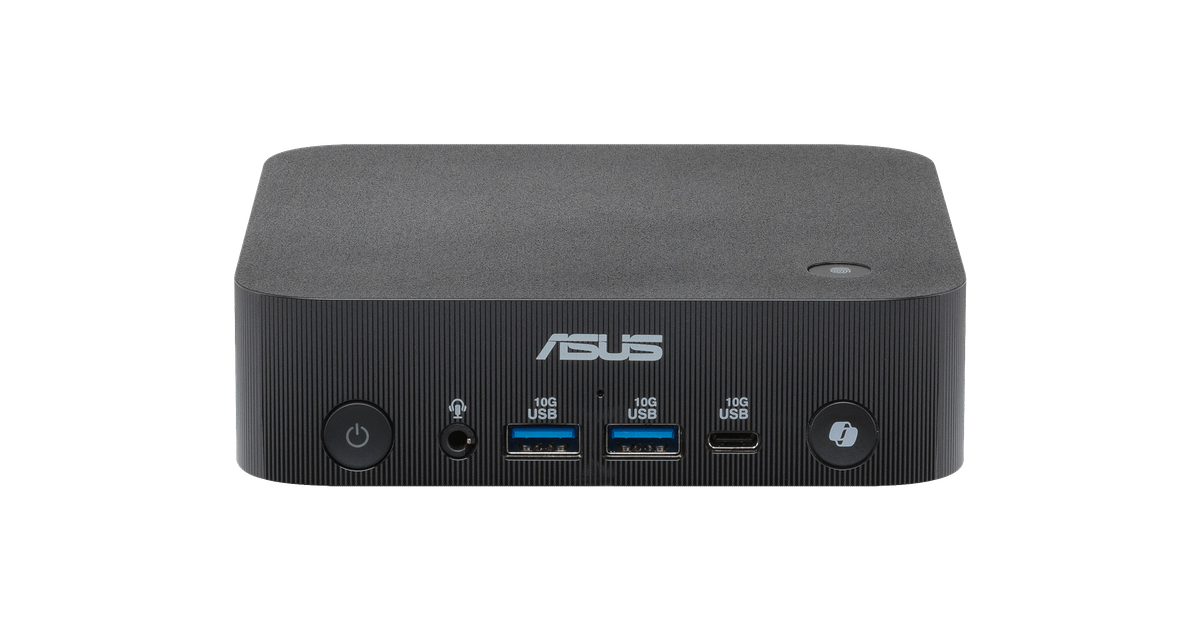
O anúncio também reforça uma tendência que vem aparecendo em mini PCs premium, workstations compactas e notebooks de IA: memória disponível para GPU/NPU está virando especificação tão importante quanto CPU, SSD ou quantidade bruta de RAM.
O que a AMD anunciou
Segundo a página oficial da AMD, o Qwen3.8 27B chega com suporte “Day 0” para rodar localmente em PCs e workstations com hardware AMD compatível. A empresa cita dois caminhos principais: sistemas com AMD Ryzen AI Max+ e uma placa AMD Radeon AI PRO R9700 de 32 GB, usando frameworks abertos como llama.cpp.
A AMD também diz que o modelo pode rodar em hardware AMD suportado com mais de 24 GB de Variable Graphics Memory (VGM) ou VRAM. Na prática, este é o ponto mais importante para compra: não basta ter “um PC com IA”; para modelos densos de 27 bilhões de parâmetros, a folga de memória pesa muito.
Por que isso importa para IA local
Rodar um modelo grande localmente não é só uma questão de privacidade. Há três vantagens práticas:
- previsibilidade de custo: o usuário compra o hardware uma vez e evita custo variável por token, embora energia, manutenção e depreciação ainda contem;
- latência e controle: fluxos de automação, coding assistants e ferramentas internas podem responder sem depender sempre de uma API externa;
- dados sensíveis: empresas pequenas, laboratórios e usuários avançados podem testar prompts e documentos com mais controle sobre onde os dados passam.
Para Jan Hardware, o recado é direto: a nova geração de “PC de IA” só faz sentido quando o conjunto entrega memória, software e suporte real aos modelos. Caso contrário, vira apenas selo de marketing.
Desempenho citado pela AMD: bom sinal, mas ainda preliminar
A AMD publicou números iniciais de geração de tokens para o Qwen3.8 27B. Segundo a empresa, os testes chegaram a até 24,5 tokens por segundo no Ryzen AI Max+ 395 e até 51,8 tokens por segundo em uma Radeon AI PRO R9700. A própria AMD classifica os resultados como preliminares e informa que os testes foram feitos no Windows com llama.cpp, backend Vulkan e configurações de MTP específicas.
| Cenário citado | Hardware | Observação prática |
|---|---|---|
| IA local em PC compacto/workstation | Ryzen AI Max+ 395 | Até 24,5 tokens/s em teste preliminar da AMD; interessante para devs e entusiastas que querem máquina única. |
| IA local com GPU dedicada | Radeon AI PRO R9700 32 GB | Até 51,8 tokens/s em teste preliminar; mais indicado para quem prioriza throughput e VRAM dedicada. |
| Requisito de memória | Mais de 24 GB de VGM/VRAM | Esse é o filtro de compra: máquinas com pouca memória gráfica podem ficar fora do uso confortável. |
Esses números não devem ser lidos como benchmark independente. Eles servem como referência inicial do fornecedor e precisam ser confirmados por testes de terceiros, com diferentes quantizações, sistemas operacionais, versões de driver e cargas reais.
LM Studio, llama.cpp e Lemonade: software começa a pesar tanto quanto hardware
Outro ponto relevante é que a AMD não está falando apenas de chip. O anúncio cita LM Studio como caminho simples para baixar e testar o modelo, llama.cpp como base aberta de inferência e Lemonade como plataforma local-first da AMD para empacotar inferência em aplicativos.
Isso é importante porque o comprador brasileiro costuma olhar primeiro para o preço do equipamento. Mas, em IA local, um hardware teoricamente forte pode virar dor de cabeça se o stack de software for frágil. Suporte no primeiro dia a modelos populares diminui atrito para quem quer experimentar agentes, assistentes de programação, busca local em documentos e automações pessoais.
Impacto para compra no Brasil
O anúncio não significa que todo mundo deva comprar uma workstation cara imediatamente. Para a maioria dos usuários, modelos menores e bem quantizados ainda podem entregar melhor custo-benefício. Porém, para quem quer rodar modelos densos maiores localmente, a mensagem é clara:
- priorize máquinas com bastante memória compartilhada ou VRAM;
- verifique se o modelo que você pretende usar tem suporte real em LM Studio, llama.cpp, Ollama ou stack equivalente;
- não compre apenas pelo selo “AI PC”; olhe memória gráfica disponível, drivers e comunidade;
- espere testes independentes antes de pagar ágio por lançamento.
O que está confirmado
- A AMD publicou uma página oficial dizendo que oferece suporte Day 0 ao Qwen3.8 27B em Ryzen AI Max+ e Radeon AI PRO.
- A empresa cita uso por LM Studio e frameworks como llama.cpp.
- A AMD informa requisito aproximado de mais de 24 GB de VGM ou VRAM para rodar o modelo confortavelmente.
- Os números de 24,5 tokens/s e 51,8 tokens/s são resultados preliminares divulgados pela própria AMD, não uma análise independente.
O que ainda falta saber
- Como o Qwen3.8 27B se comporta em testes independentes com diferentes quantizações.
- Quais notebooks, mini PCs e workstations no Brasil chegarão com configuração de memória adequada e preço competitivo.
- Se o suporte em Linux será tão simples quanto no fluxo citado pela AMD para Windows e Vulkan.
- Como o consumo de energia se compara ao uso de APIs na nuvem em rotinas reais de trabalho.
Conclusão
O suporte da AMD ao Qwen3.8 27B é uma notícia pequena no formato, mas grande no sinal de mercado: IA local está deixando de ser experimento de fórum para virar argumento concreto de compra em PCs premium. Para Janio e para o leitor do Jan Hardware, a recomendação é pragmática: acompanhe, teste quando possível, mas compre com foco em memória, suporte de software e custo total — não apenas no nome do processador.
FAQ
Preciso de um Ryzen AI Max para rodar IA local?
Não necessariamente. Modelos menores rodam em muitos PCs. O Ryzen AI Max entra como opção mais forte para quem quer modelos maiores e mais memória disponível localmente.
24 GB de VRAM são obrigatórios?
Para o cenário específico citado pela AMD, a empresa fala em mais de 24 GB de VGM ou VRAM para rodar o Qwen3.8 27B confortavelmente. Modelos menores ou quantizações diferentes podem exigir menos.
Os números da AMD são benchmark definitivo?
Não. São resultados preliminares informados pela própria AMD. O ideal é aguardar testes independentes em diferentes configurações.
Isso substitui ChatGPT, Claude ou Gemini?
Não para todos os casos. IA local pode ser ótima para privacidade, automações e previsibilidade de custo, mas serviços em nuvem ainda podem ter modelos maiores, recursos integrados e melhor conveniência.